whereq.com 开源了:地图、爬虫,以及它读到的所有数据

一枚图钉,其实只是一句很小的话
站在多伦多的一条街上,看着眼前这个门牌号,地图只会告诉你一句话:这里有一枚图钉。一家咖啡馆,一间医院,一所学校,也许还有一个停车场。
但一个地方本身是一大堆话,而图钉是其中最不重要的那句。
这个地址属于哪个学区 catchment?走路能到图书馆吗,是哪一家?街角加油站今天收 1.42 还是 1.79?这栋楼落在 ward 里、neighbourhood 里,还是两者都算?上周这条街上出过什么事?
这些答案每一条都是一份数据,而每一条都住在别的地方。学校边界在一个系统里,油价在另一个系统里,行政区划在第三个系统里,本地新闻又在第四个系统里。你看到的地图,不过是它们全部对齐之后的结果。
所以我把「对齐」这件事单独做成了一个层
做这个应用的时候,最让我意外的是:真正的工作根本不在地图本身。
画图钉是简单的一半。难的一半是,地图本质上是一次 join。每一层都要有自己的键、自己的许可条款、自己的速率限制,还有自己对于「一个地方」的理解——而一个 POI(地址上的一个点)和一个行政区(把地址装进去的一个多边形),根本不是同一种东西,哪怕你可以随手把它们放在同一个下拉菜单里。
所以这个应用的第一版里躺着三个互不相干的抓取脚本,各自为自己的数据集而写,各自握着一把 API key,也各自在某个凌晨三点悄悄坏掉。
几乎世界上每一个应用都长成这个形状:十个应用,十个爬虫,十个每晚都会失败的作业。
解法是把「取数据」本身变成一个独立的层——一个进程、一个节奏、一处允许外部世界进入这个应用的口子。
我把它叫做爬虫,这是整个仓库里我最满意的部分。
爬虫
地图上的一切,都是被爬下来的:
- whereq.cloud —— 加油站及其实时油价、聚合价格序列,以及行政区划:省、区域、市镇、城市、城镇、ward、neighbourhood,还带着它们真实的边界轮廓。
- OpenStreetMap —— 你身边的地点。咖啡、餐饮、停车、药房、walk-in clinic、广场、图书馆。
- RSS 与 JSON 信息源 —— 也就是地图右上角可以开关的那些本地新闻、活动、故事与话题。
一个账号,一把 key,一份速率配额。whereq.cloud 的 API 每分钟允许 30 次请求,所以两条 whereq.cloud 爬虫共用同一个限流器——两个各自独立的限流器各放行 30 次/分,只会互相把对方顶成 429。它按 coverage target 轮转(一个国家、一个省、一座城市、一个地图视口),所以单次 tick 绝不会向数据源讨要整块大陆;某个 target 失败了,会在下一个 tick 重试,而不是干等一个间隔。
内容爬虫是同一个思路,只是多接了一个解析器:从登记在册的信息源里发现条目,做归一化,抽出地点,用一条 provider 链反查坐标,分类,然后 upsert 进数据库。某条信息源失联时,它只会把该源的 last_status 记为 error,整轮抓取照常继续。
whereq.com
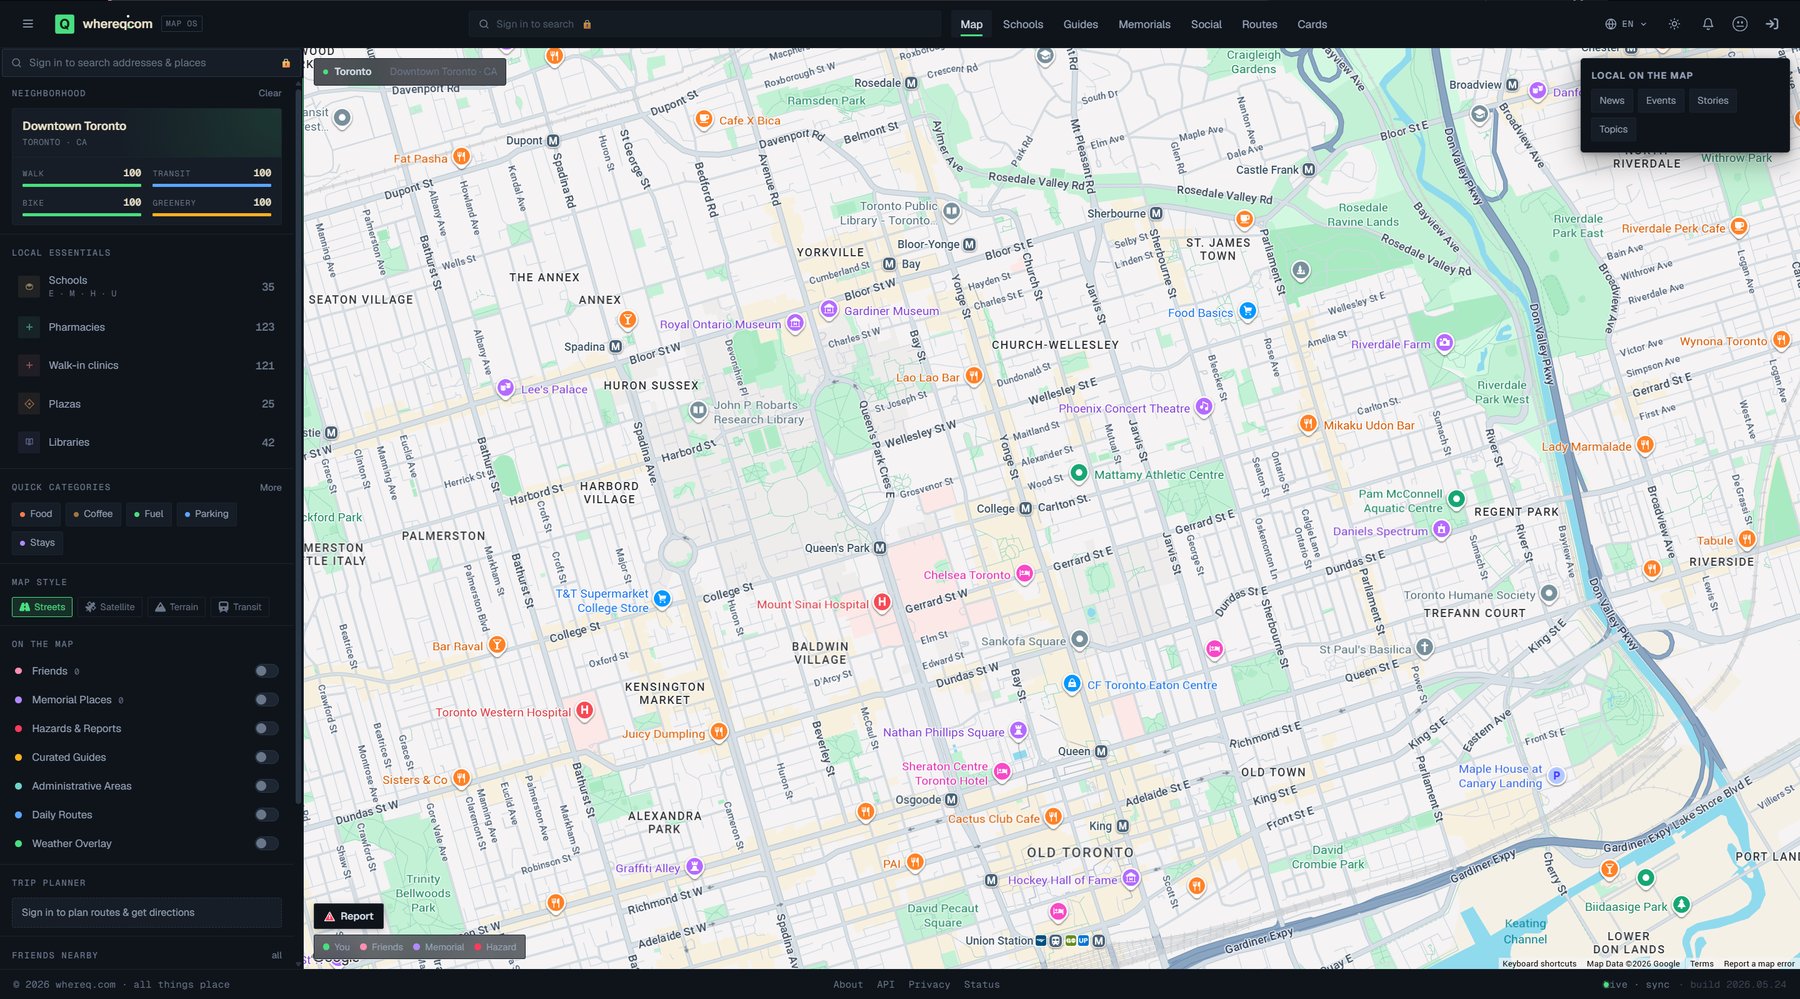
多伦多市中心。左侧:neighbourhood 指南、本地必备、快捷分类;再往下是图层——行政区划、隐患、精选指南、好友、每日路线。右上角:爬虫从信息源拉回来的内容。
whereq.com 是一个以地图为中心的地点平台。打开它,你看到身边的地点;再打开其中任何一个,得到的是一页完整资料——地址、营业时间、分类、照片、到那里的路线,以及人们留下的笔记。
今天它能做的事包括:
- 地点与附近搜索 —— POI 地图,加上一个把半径内所有东西合并成单一排序列表的附近搜索。
- 地点卡片 —— 每个地点一页完整页面,由人来写,不是由信息源生成的。
- 学校 —— 覆盖范围内的每一所学校,连同它的学区边界,直接画在地图上。
- 隐患 —— 环境与基础设施隐患,标注在地图上,也允许上报。
- 油价 —— 加油站与实时价格,从 whereq.cloud 爬来。
- 地理 —— 把地点「装进去」的那些区域,带真实轮廓。
- 路线、好友、收藏地点、通知 —— 一张地图应用该有的那些社交部分。
- 英文、法文与简体中文,贯穿整个界面。
技术说明
- 前端 —— React 18、TypeScript、Vite、Tailwind。类型检查是严格的(
noUnusedLocals、noUnusedParameters),它也是前端唯一真正的关卡。 - 后端 —— FastAPI、SQLAlchemy、Pydantic,18 个 Alembic migration。
- 数据库 —— PostgreSQL 17 + PostGIS。真正的 geometry 列、GiST 索引,以及不会被简化边界骗过的点在多边形内判定。
- 许可 —— MIT,覆盖整个仓库,包括爬虫。
- 测试 —— 235 个,不需要数据库,也不需要网络;少数几个需要真实 Postgres 的用例是可选开启的。
这篇文章不是文档。 文档是仓库本身:安装指南、爬虫指南、库表结构、数据来源及其许可。我更希望你直接去读那些,而不是听我一面之词。
👉 github.com/whereq/WhereQ-com
跑起来:
git clone https://github.com/whereq/WhereQ-com.git
cd WhereQ-com
cp docker/.env.example docker/.env
# 设置 POSTGRES_PASSWORD 和 SECRET_KEY
docker compose -f docker/docker-compose.yml up -d --build
这就是完整的一栈——带 PostGIS 的 PostgreSQL、migration、API、爬虫,以及由 nginx 托管的前端。启动后访问 localhost:3743。
构建、测试、运行都不需要任何 key。 把 OIDC 留空,它就以匿名模式运行,登录入口自动隐藏;把 whereq.cloud 的 key 留空,油价面板就是空的,地理数据则回落到它的公开层。Google Maps 的 key 只决定地图本身画不画得出来。
为什么现在把它放出来
这个仓库只有 一个 commit。
这不是失误,也不是从模板起的新项目。我在发布前重写了它的历史,因为这个应用的历史里,藏着一些本来就不该离开我电脑的东西——凭据字面量、一场许可证明确不允许再分发的学校数据实验、还有我写给自己看的部署笔记。git 历史是一份永久的公开记录,事情发生之后再删掉一行,并不能把已经泄露的东西收回来。
所以历史被重写,私人的东西从每一个 commit 里清了出去,公开出来的只剩代码、migration、CI 和文档。旧的 commit 不存在于任何读者能触及的地方。
再往下一层,理由其实更朴素:这张地图是整个 WhereQ Universe 里其他应用要读的那一块。它本来就在对外提供一个带密钥的地理编码 API——geocode、autocomplete、反查、路线、matrix、静态地图——好让同门的其他应用不必自己持有 Google key。既然大家都要依赖这个服务,那么它背后的爬虫、以及这张地图本身,就应该让任何想自己跑一份的人读得到。
如果你想为自己所在的城市跑一份自己的地图,这是一份起点,不是一个成品。拿走吧。
致谢
这个应用站在别人的劳动之上,装作不是那样才是不诚实的。
- whereq.cloud —— 我们自己的数据平台。加油站、实时油价、价格序列和行政区划都由它提供,本应用负责爬取。油价数据是授权且计费的;地理数据则是开放数据。
- OpenStreetMap 的贡献者们 —— POI 图层、neighbourhood 几何,以及人口普查分区,采用 ODbL 1.0。署名信息随每一行数据一起走,页脚里也有。
- geoBoundaries —— 正式的行政边界,采用 CC-BY 4.0。
- Google Maps Platform —— 地图本身、作为兜底的地理编码和路线规划。他们的署名格式是每一个地图界面都必须带的,应用里已经带上。
- geocode.maps.co、LocationIQ、Geocodio、Nominatim —— 免费的几档地理编码服务,排付费 provider 前面试,这样付费额度只在前面全都用尽时才会被消耗。
- feedparser,以及构建这个仓库所依赖的整个 Python 与 JavaScript 生态。完整清单在
NOTICE里。
也要谢谢那些告诉我图钉画错了、药店漏掉了、油价过期了的人:这张地图之所以更好,是因为你们说它不好。
如果你自己跑起了一份,或者为你的城市改造了它——我很想听听。