财经今日 开源了:界面、它读的库表结构,以及中间的 API

一个交易日,是六个标签页
九点二十五,集合竞价结束。九点半,开盘。从这一刻起,接下来四个小时, 市场一直在说话:一次公开市场操作、一个期货点位、一个指数点位、一份征求意见 稿、一份公司公告,再加上一篇分析——而这两者到底差在哪。
这些消息都是真的,也都真实存在。只是它们不在同一个地方。
于是你打开六个标签页:行情快讯、指数页面、板块热力图、日历、公告检索、还有 一个论坛。它们各自的版式、配色、关注点都不一样,而且大多是为别人的问题而 做的。
我一直想要的是一块板子。一屏之内,热榜、7×24 快讯、板块热力、经济日历、个股 热榜同时都在;而且每个面板回答的都是同一个问题:发生了什么变化,有多重要。
财经今日(CaiJing Today) 就是这块板子。它以中文为默认界面,因为市场先说 中文;英文放在旁边,一键可切。
这块板子
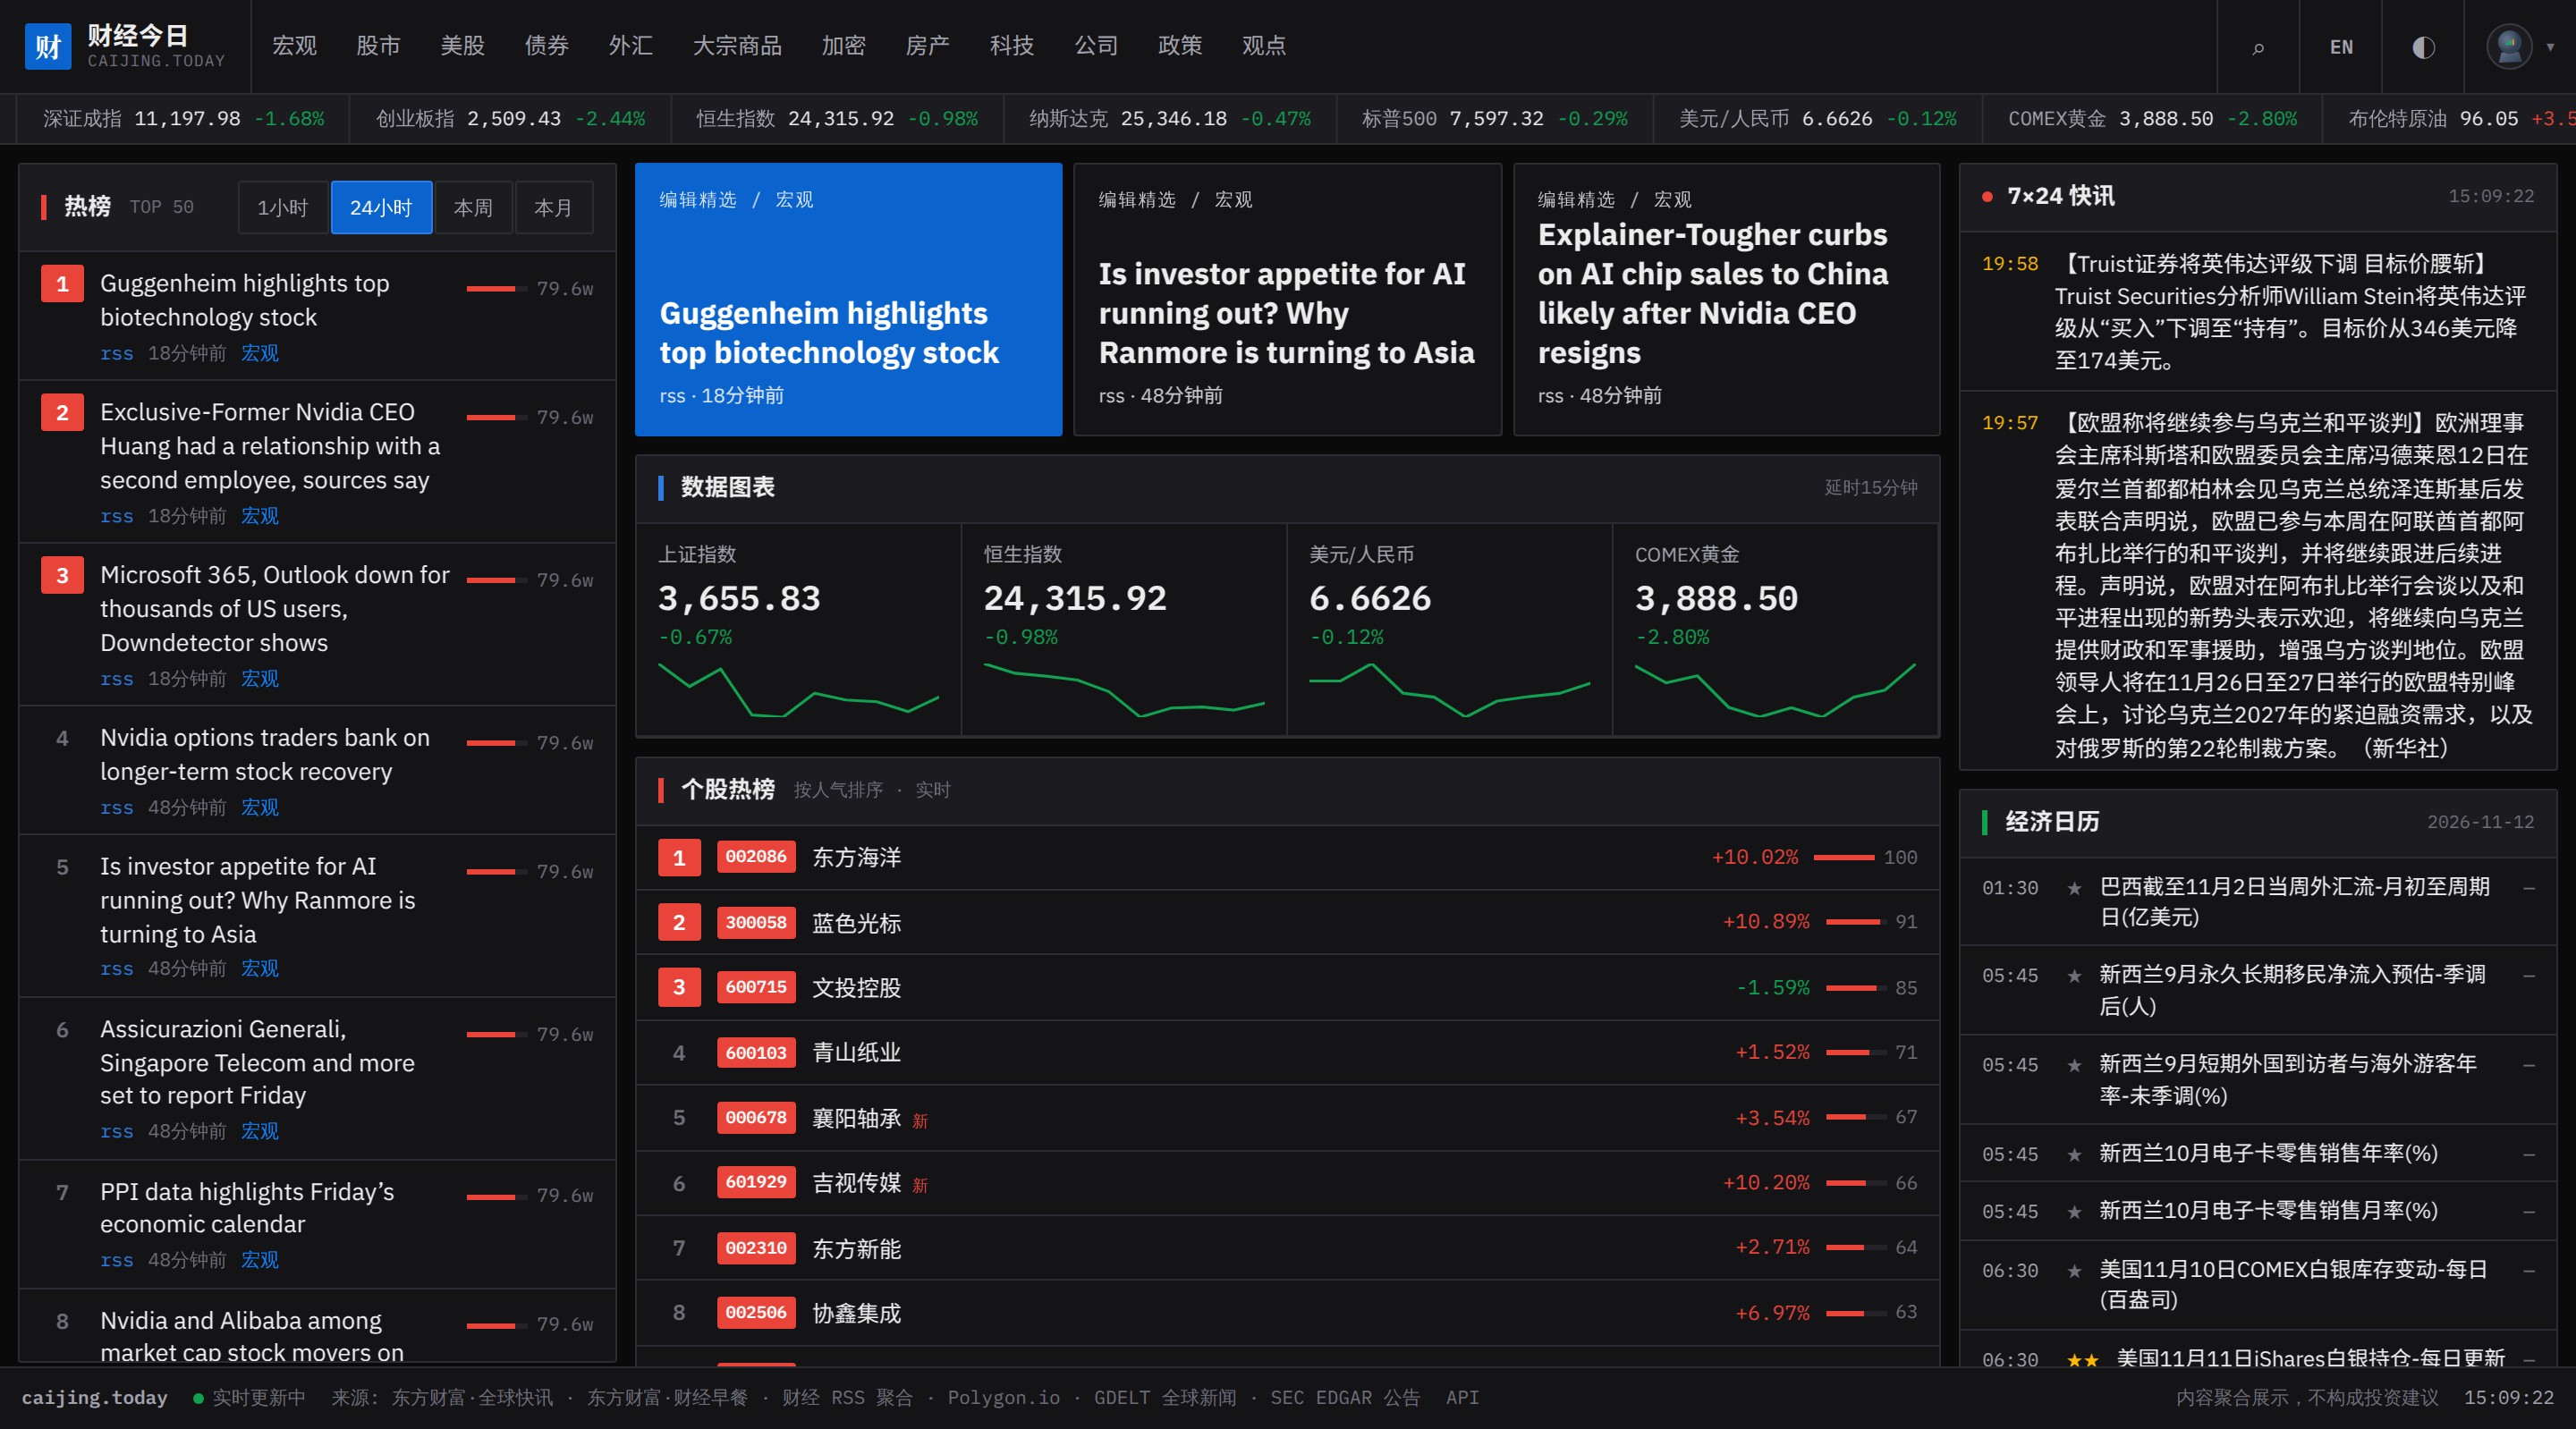
这是运行中的站点——caijing.today——里面是真实数据。左侧是热榜 TOP 50,配 1 小时 / 24 小时 / 本周 / 本月四档时间窗和热度条;中间是编辑精选、 行情图表和个股热榜;右侧是 7×24 快讯、经济日历和全球市场行情;顶部那条是滚动的 行情带。
打开它,版式是刻意做密的。顶部一条行情带横向滚动。往下是三栏面板,每一个都是 同一套数据库的一个切面,谁也不替谁做总结。
- 热榜 / TOP 50 —— 按热度排序的新闻,右侧可切换时间窗。这里的热度不是编辑 判断,而是由发布时间、该条所挂分析的可信度,以及情绪强度共同算出来的。
- 7×24 快讯 —— 快讯流。短、带时间戳,有自己的节奏;你读一篇五分钟前打开 的稿子,它也还在旁边走着。
- 个股热榜 —— 个股热榜,自带一套排序。
- 分类导航 —— 十二个分类:宏观、股市、美股、债券、外汇、大宗商品、加密、 房产、科技、公司、政策、观点。这不是手工维护的分类表——每一条内容是按它的 信号类型、板块、地域和标签归类的,你也可以手动改。
- 经济日历 —— 当天的预定数据发布,带重要度。
- 数据图表 / 行业板块 / 加密市场 / 热搜关键词 —— 走势图、带资金流的板块 热力、加密板块,以及大家正在搜什么。
整套界面两种语言,切换按钮在页头。中文不是英文的翻译——中文才是最初的版式, 英文是后来并排加上去的。
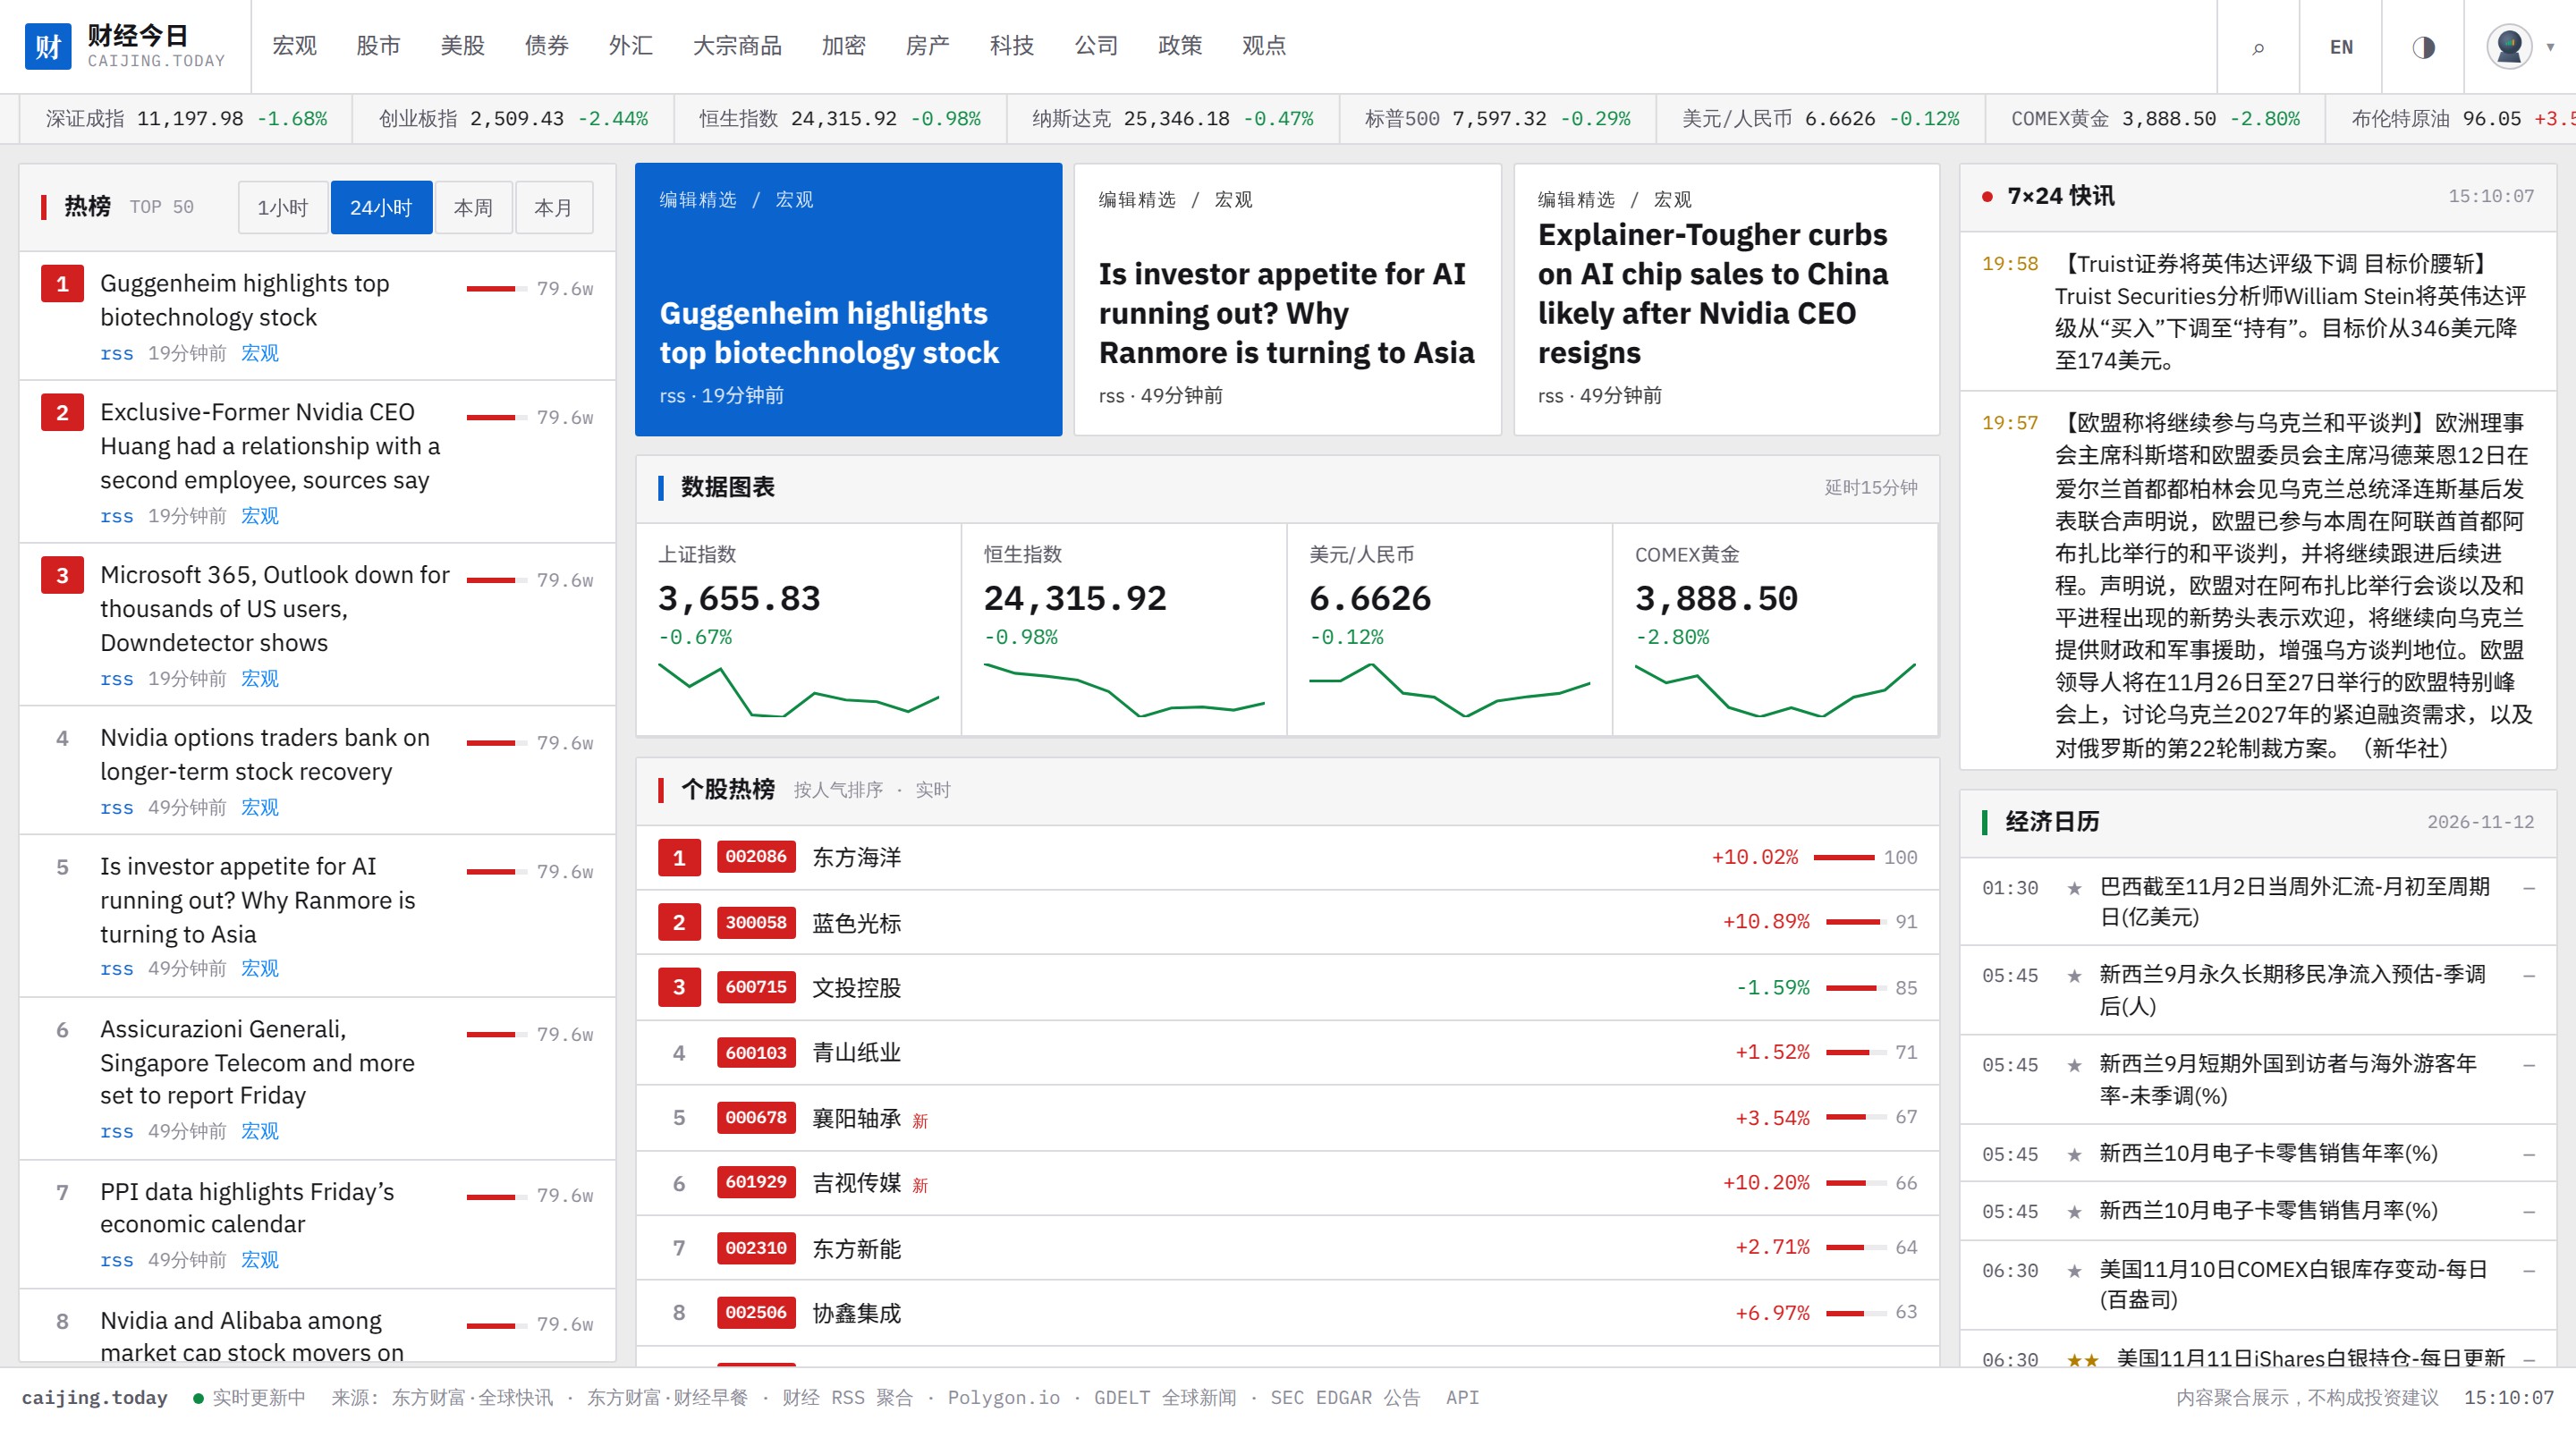
同一块板子的浅色主题。板子默认是深色的,页头的切换按钮可以换,切换结果会 被记住。
技术说明
- 前端 —— React 19、TypeScript、Vite、TanStack Query、i18next。类型严格, 55 个测试。
- 后端 —— FastAPI、SQLAlchemy 2(asyncpg 异步驱动)、Pydantic。 只读:这个服务从不写入它所读的数据库。
- 数据库 —— PostgreSQL 17。15 张表、2 个视图,以
docs/SCHEMA.sql的形式公开。 - API ——
/api/v1下 17 个接口,全部是读。 - 许可 —— MIT,覆盖整个仓库。
- 测试 —— 后端 25 个、前端 55 个,CI 里四道关:后端测试、一道把库表契约 真正灌进 PostgreSQL 并和 ORM 映射对账的 schema 检查、前端测试,以及四个镜像 的 Docker 构建。
这篇文章不是文档。 文档是仓库本身:库表契约、安装指南、数据来源的规矩、 测试矩阵。我更希望你直接去读那些,而不是听我一面之词。
👉 github.com/whereq/CaiJing-Today
跑起来:
git clone https://github.com/whereq/CaiJing-Today.git
cd CaiJing-Today

cp docker/.env.example docker/.env
docker compose -f docker/docker-compose.yml up -d --build
然后打开 http://localhost:8080。这就是完整的一栈——PostgreSQL 17、库表契约、
演示数据、API 和前端。API 在 http://localhost:8000,交互式文档在 /docs。
构建、测试、运行都不需要任何 key。 docker/.env.example 里的默认值是本地
开发用的凭据,不是密钥;而且不需要身份提供者:浏览是公开的,所以界面停在匿名
模式,登录入口自动隐藏。
为什么现在把它放出来
因为采集器是那部分不开源的,而库表结构是开源的。
这个仓库把库表结构当作一份明确的契约公开——15 张表、2 个视图,列的类型、唯一 约束、快照的纪律、时间的 UTC 规矩——再加上一个只读它的 FastAPI 服务。生产环境 里往这些表里灌数据的采集器是另一个组件。
我觉得这个切分才是有用的地方。库表结构不是谁家数据库的导出物,它是两个允许 由不同的人写的程序之间的约定。如果你想要自己的采集器——自己的信源、自己的节 奏、自己对「一条新闻」的理解——那就写一个往这些表里插入的组件,API 和界面不 改一行代码就会把它伺服出来。
这就是全部的扩展点,规矩写在
docs/data-sources.md里:
published_at 是什么时区、为什么快照表要新增一个 as_of 而不是更新、哪些分
类 id 是合法的、热度分数由什么构成。
有一句必须说清楚的话。 MIT 许可覆盖的是代码,它对往数据库里放的数据只 字未提。采集器取回来的标题、行情和公告,权利属于发布它们的那家机构,各有各的 条款;财经通讯社、免费公开数据门户和行情数据商给的授权根本不是一回事。你要是 接了真实数据,守约是你的事,不是这个项目的。
还有关于演示数据,说白了:里面每一行都是编的。标题带【示例】/ [sample] 前缀,
价格是假的,日历条目是占位的,链接用的是保留域名 .invalid,热榜里的代码是
DEMO-001 … DEMO-010 而不是真实股票代码。这是有意的——真实代码配一个编出来
的热度,读起来就成了投资建议。
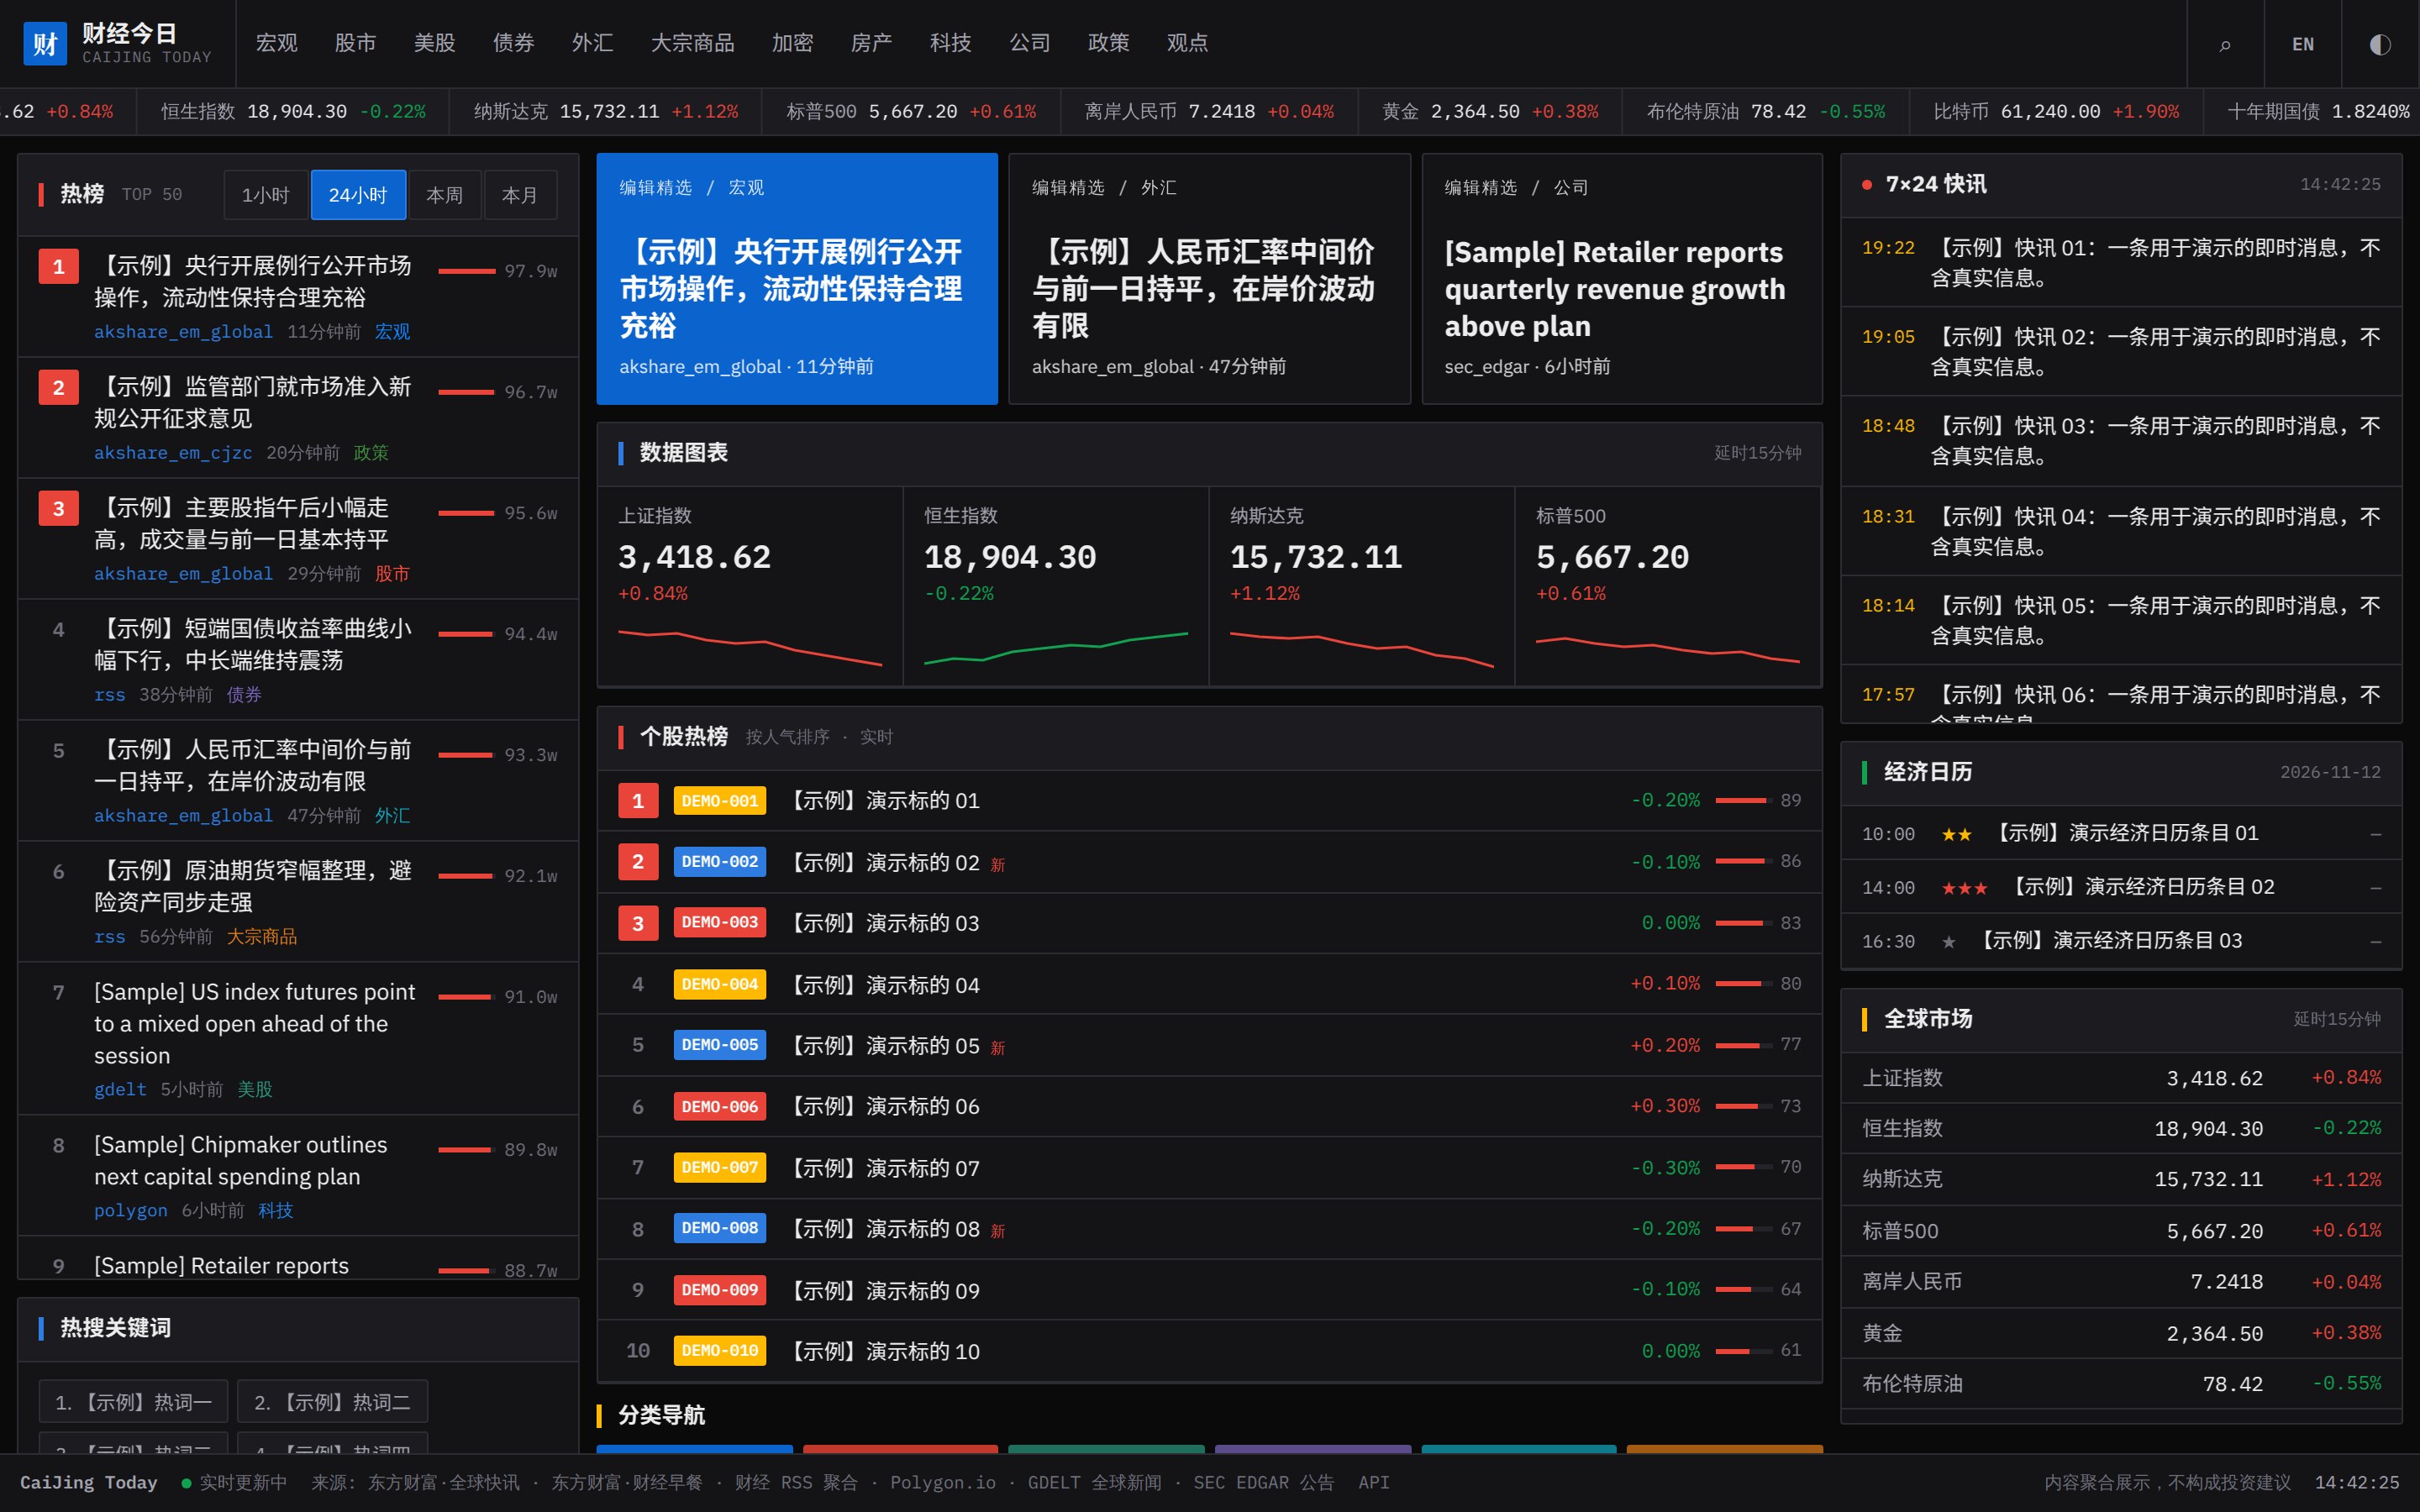
这就是一份全新 checkout 跑起来的样子:同一块板子,跑在合成演示数据上。每条
标题都标着【示例】,代码全是 DEMO-001 … DEMO-010,里面没有一个数字是真的。
界面和线上一样,默认中文。
致谢
这个应用站在别人的劳动之上,装作不是那样才是不诚实的。
- Polygon.io —— 行情数据。行情带、指数点位、走势图都 来自它。
- GDELT —— 全球新闻索引,对应
gdelt这个 信源 id。 - SEC EDGAR —— 美国公告索引,对应
sec_edgar这个信源 id。 - 东方财富 —— 界面上标注为
akshare_em_global和akshare_em_cjzc的全球 快讯与财经早餐信源。 - 财经 RSS 聚合 ——
rss这个信源 id 背后的财经 RSS 信息源。 - React、Vite、
TanStack Query、
i18next、
FastAPI、
SQLAlchemy、
Pydantic、
PostgreSQL、
nginx 和 Docker —— 这个
仓库所依赖的技术栈。依赖清单在
NOTICE里。
演示数据集则不归任何人所有——这恰恰是它的意义:它是合成的,它自己写明了这一点, 它的存在只是为了让一份全新的 checkout 起来就有东西可看。
如果你照着这份契约写了一个采集器——或者把它改成一块服务于别的市场的板子—— 我很想听听。